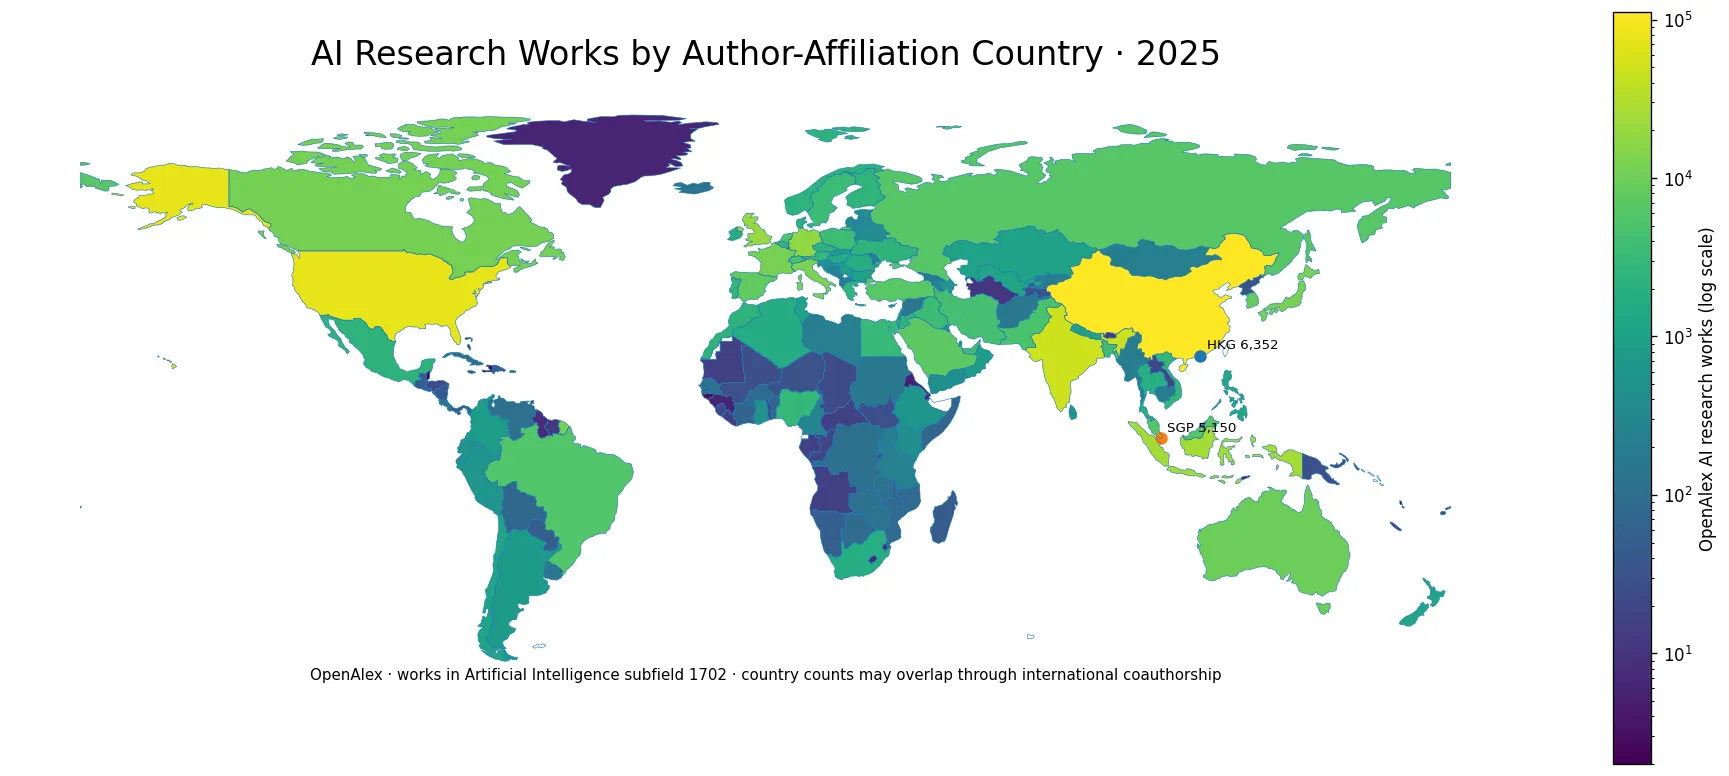
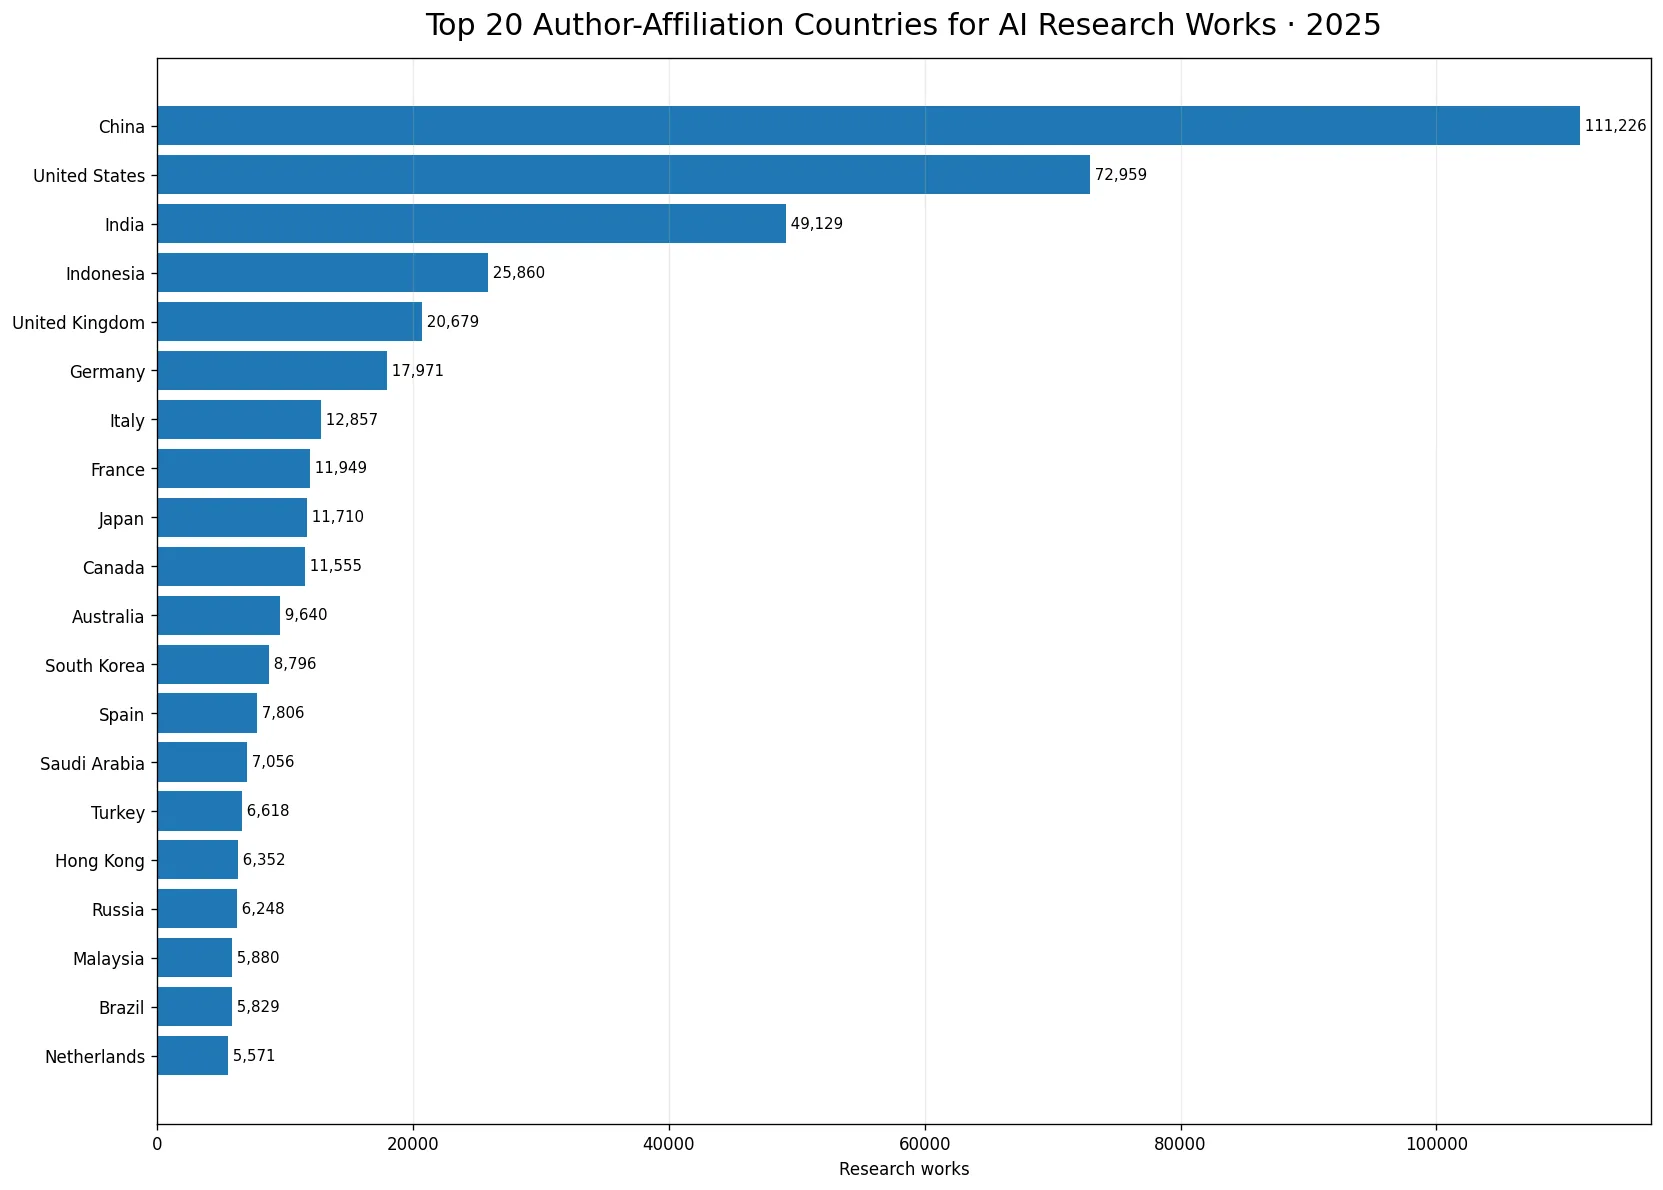
La distribución geográfica de la investigación en inteligencia artificial puede observarse desde muchos ángulos, pero esta comparación utiliza uno muy específico: el número de trabajos de 2025 en OpenAlex asignados al subcampo de Inteligencia Artificial 1702 y agrupados por los países vinculados a las afiliaciones de sus autores. Bajo esa definición, China registra 111.226 trabajos, Estados Unidos 72.959 e India 49.129. Después aparecen Indonesia con 25.860 y Reino Unido con 20.679.
La palabra clave es afiliación. El conteo no asigna cada publicación a un único país. Si un trabajo incluye autores afiliados a instituciones de varios países, ese mismo trabajo puede contribuir al conteo de cada uno de esos países. Por eso los valores nacionales sirven para comparar con qué frecuencia aparecen las afiliaciones de cada territorio en la producción de IA registrada por OpenAlex, pero no deben sumarse para calcular un total mundial único de publicaciones.
Índice
China, Estados Unidos e India forman un primer grupo muy separado
China encabeza la instantánea con 111.226 trabajos, aproximadamente 1,52 veces el conteo de Estados Unidos y 2,26 veces el de India. Estados Unidos registra 72.959, cerca de 1,49 veces el valor indio de 49.129. Después hay un descenso importante hacia Indonesia, con 25.860, y Reino Unido, con 20.679. Alemania completa el siguiente escalón con 17.971.
Estas distancias muestran que la parte superior de la distribución no forma un bloque uniforme. La diferencia entre el primer y el segundo país es grande, y vuelve a producirse otro salto antes de India y del resto. Más abajo, los valores empiezan a acercarse entre sí. Esa forma de la distribución es más informativa que una clasificación que trate todos los primeros puestos como si fueran equivalentes.
Además, el número de trabajos no explica por sí solo por qué un país aparece en una posición concreta. El tamaño del sistema universitario y científico, la cantidad de instituciones activas, la composición temática, la colaboración internacional y la cobertura bibliográfica pueden influir en el resultado. Esta serie describe escala de presencia en afiliaciones vinculadas a trabajos de IA; no prueba las causas de esa escala.
Diez países superan 10.000 trabajos
Un total de diez grupos nacionales alcanzan al menos 10.000 trabajos. Después de China, Estados Unidos, India, Indonesia, Reino Unido y Alemania aparecen Italia con 12.857, Francia con 11.949, Japón con 11.710 y Canadá con 11.555. El umbral de 5.000 trabajos lo superan 21 países, mientras que 59 llegan al menos a 1.000.
| País o economía | Trabajos de IA |
|---|---|
| China | 111.226 |
| Estados Unidos | 72.959 |
| India | 49.129 |
| Indonesia | 25.860 |
| Reino Unido | 20.679 |
| Alemania | 17.971 |
| Italia | 12.857 |
| Francia | 11.949 |
| Japón | 11.710 |
| Canadá | 11.555 |
| Australia | 9.640 |
| Corea del Sur | 8.796 |
| España | 7.806 |
| Arabia Saudita | 7.056 |
| Turquía | 6.618 |
| Hong Kong | 6.352 |
| Rusia | 6.248 |
| Malasia | 5.880 |
| Brasil | 5.829 |
| Países Bajos | 5.571 |
La mediana de 143,5 trabajos está muy lejos de la media
Los 212 grupos nacionales presentan una distribución extremadamente asimétrica. La media aritmética es de 2.534,5 trabajos, pero la mediana es solo 143,5. El primer cuartil se sitúa en 16,75 y el tercero en 1.278,75. La media es aproximadamente diecisiete veces la mediana, una señal clara de que un número pequeño de valores muy altos eleva mucho el promedio.
Por eso sería engañoso describir al país “típico” como uno con unos 2.500 trabajos. La mitad de los grupos nacionales se sitúa por debajo de aproximadamente 144 trabajos, mientras que los líderes cuentan decenas de miles y China supera los cien mil. La mediana describe mucho mejor el centro de la distribución cuando hay una cola superior tan larga.
Esta diferencia también explica la necesidad de representar el mapa con una escala logarítmica. En una escala lineal, los valores de China, Estados Unidos e India dominarían la gama de colores y muchos países con cientos o miles de trabajos aparecerían casi iguales. La transformación se utiliza solo para la visualización; los conteos originales no se modifican en la tabla ni en el gráfico de los veinte primeros.
Más de la mitad de los grupos nacionales alcanzan 100 trabajos
De los 212 grupos, 117 tienen al menos 100 trabajos y 169 alcanzan al menos 10. Esto deja 43 grupos por debajo de 10. El mínimo observado es un trabajo. Estos valores pequeños son observaciones reales de la instantánea y no ceros creados para rellenar datos ausentes.
Todos los 212 códigos o claves nacionales de la instantánea contienen un valor numérico. Sin embargo, algunos territorios pequeños no aparecen como polígonos independientes en la cartografía mundial de baja resolución utilizada para el mapa. Por esa razón, la visualización geográfica no puede representar con el mismo detalle todos los casos, aunque el ranking y las tablas conserven sus valores.
La amplitud geográfica es, en sí misma, uno de los resultados más claros. La producción de IA asociada a afiliaciones aparece en un conjunto muy amplio de países y territorios, no solo en las economías con mayores conteos. El tamaño de los grupos varía enormemente, pero la presencia bibliográfica del subcampo se extiende mucho más allá de los primeros puestos.
La colaboración internacional impide sumar los países como si fueran exclusivos
Esta es la limitación metodológica más importante. Un artículo puede incluir autores afiliados a instituciones de China, Estados Unidos, Alemania y otros países. Cuando OpenAlex agrupa por países asociados a las autorías, ese mismo trabajo puede contribuir a varios grupos nacionales. Los conteos, por tanto, no son categorías mutuamente excluyentes.
Sumar los 212 valores produciría un total de apariciones de afiliaciones nacionales dentro de trabajos agrupados, no un número de publicaciones únicas. Tampoco sería correcto utilizar esa suma como denominador para calcular una supuesta cuota mundial de cada país. Si la pregunta fuera cuántos trabajos únicos de IA existen globalmente en 2025 bajo el mismo filtro, habría que consultar el total sin agrupar por país.
El agrupamiento usado aquí responde a otra pregunta: ¿en qué países se localizan las afiliaciones institucionales asociadas con trabajos de IA? Esa pregunta es útil para estudiar presencia geográfica y colaboración, pero debe mantenerse separada de una medición de producción nacional exclusiva.
El país de afiliación no es la nacionalidad del investigador
OpenAlex vincula las autorías con instituciones y, a partir de esas afiliaciones, con países. El país asignado a un trabajo en este agrupamiento refleja por tanto la ubicación institucional registrada, no la ciudadanía del autor. Un investigador puede tener una nacionalidad distinta del país de su universidad o centro de investigación, y una misma persona puede mantener afiliaciones múltiples.
La métrica tampoco indica dónde se realizó físicamente un experimento, dónde se entrenó un modelo o dónde se financió el proyecto. Describe el país conectado con la afiliación institucional de la autoría en el registro bibliográfico. Esta diferencia es fundamental para no interpretar el mapa como una distribución de nacionalidades de investigadores.
Los valores de 2025 pueden revisarse con el tiempo
OpenAlex actualiza continuamente registros bibliográficos, asignaciones temáticas, identidades de autores y enlaces institucionales. Un trabajo publicado en 2025 puede incorporarse más tarde al índice, recibir una afiliación corregida o cambiar su clasificación temática a medida que mejora el metadato. Por eso las cifras deben entenderse como una instantánea y no como un censo histórico inmutable.
La instantánea verificada utilizada para este análisis corresponde al 20 de septiembre de 2026. Dos capturas verificadas en días consecutivos ya mostraban pequeñas revisiones en varios países, aunque la estructura general del ranking permanecía estable. Para estudios reproducibles conviene conservar la fecha de extracción o repetir siempre el mismo filtro y método de agrupación.
Volumen de publicaciones no equivale a impacto científico
Un conteo alto indica que muchas publicaciones de IA están asociadas con afiliaciones de un país, pero no demuestra mayor impacto de citas, más calidad, mayor originalidad ni mejores resultados económicos. Esas preguntas requieren indicadores adicionales. El número de trabajos es una medida de volumen y cobertura, no una puntuación completa de capacidad nacional en inteligencia artificial.
Para estudiar impacto podrían añadirse citas, indicadores normalizados por campo o participación de trabajos muy citados. Para analizar productividad podrían utilizarse denominadores como número de investigadores, gasto en I+D o capacidad institucional. La clasificación de 2025 debe leerse como una dimensión descriptiva y no como una jerarquía integral de sistemas nacionales de IA.
Qué puede decir realmente la instantánea de 2025
Las conclusiones más sólidas son descriptivas. China presenta el mayor conteo de afiliaciones asociadas a trabajos de IA, seguida por Estados Unidos e India. Diez países superan 10.000 trabajos, 21 superan 5.000 y 59 alcanzan al menos 1.000. Al mismo tiempo, la mediana de 143,5 revela que la mayor parte de los grupos nacionales se encuentra muy por debajo de los líderes.
La misma instantánea muestra una cobertura geográfica extensa en 212 países y territorios y una distribución muy sesgada hacia unos pocos conteos grandes. Lo que no puede establecer por sí sola es causalidad, crecimiento respecto a años anteriores, eficiencia científica, calidad de la colaboración o cuota exclusiva de publicaciones mundiales. Cada una de esas preguntas requiere otra metodología o un denominador diferente.
| Medida | Resultado |
|---|---|
| Grupos de país o territorio | 212 |
| Media | 2.534,5 trabajos |
| Mediana | 143,5 trabajos |
| Primer cuartil | 16,75 |
| Tercer cuartil | 1.278,75 |
| 10.000 trabajos o más | 10 países |
| 5.000 trabajos o más | 21 países |
| 1.000 trabajos o más | 59 países |
| 100 trabajos o más | 117 países |
| 10 trabajos o más | 169 países |
Fuente y método de cálculo
La fuente es la API de Works de OpenAlex, operada por OurResearch. El filtro utiliza publication_year=2025 y topics.subfield.id=1702 para Inteligencia Artificial, y posteriormente agrupa los resultados mediante authorships.countries. La instantánea verificada contiene 212 claves nacionales.
Las estadísticas descriptivas calculadas sobre esos conteos son una media de 2.534,5, una mediana de 143,5, un primer cuartil de 16,75 y un tercer cuartil de 1.278,75. Los conteos nacionales no son mutuamente excluyentes porque los trabajos con coautoría internacional pueden asociarse con varios países. Por esa razón no se calcula una cuota mundial utilizando la suma de los grupos nacionales.
Preguntas frecuentes
¿Qué país aparece con más trabajos de investigación en IA en 2025?
China registra 111.226 trabajos asociados a afiliaciones de autor, seguida por Estados Unidos con 72.959 e India con 49.129.
¿Se pueden sumar los 212 conteos nacionales para obtener el total mundial de trabajos de IA?
No. Un mismo trabajo con autores afiliados en varios países puede aparecer en varios grupos nacionales, por lo que los conteos no son mutuamente excluyentes.
¿El país de afiliación equivale a la nacionalidad del investigador?
No. OpenAlex agrupa por los países vinculados a las afiliaciones institucionales de las autorías, no por ciudadanía o nacionalidad.
¿Los valores de 2025 pueden cambiar después?
Sí. OpenAlex actualiza registros bibliográficos, afiliaciones y asignaciones temáticas, por lo que una instantánea histórica puede recibir pequeñas revisiones.
Artículos relacionados
Los mapas ofrecidos por Green Map son mapas editados y elaborados por nosotros, utilizando como referencia fuentes de datos geográficos abiertos como geoBoundaries, Natural Earth, OpenStreetMap y datos abiertos de gobiernos y organismos públicos.
Las imágenes de los mapas no redistribuyen los archivos de datos originales. Son materiales visuales editados y diseñados para su uso en educación, presentaciones, documentos, blogs y otras referencias gráficas. Este aviso informa sobre las principales fuentes de datos utilizadas como referencia en la elaboración de los mapas de Green Map.