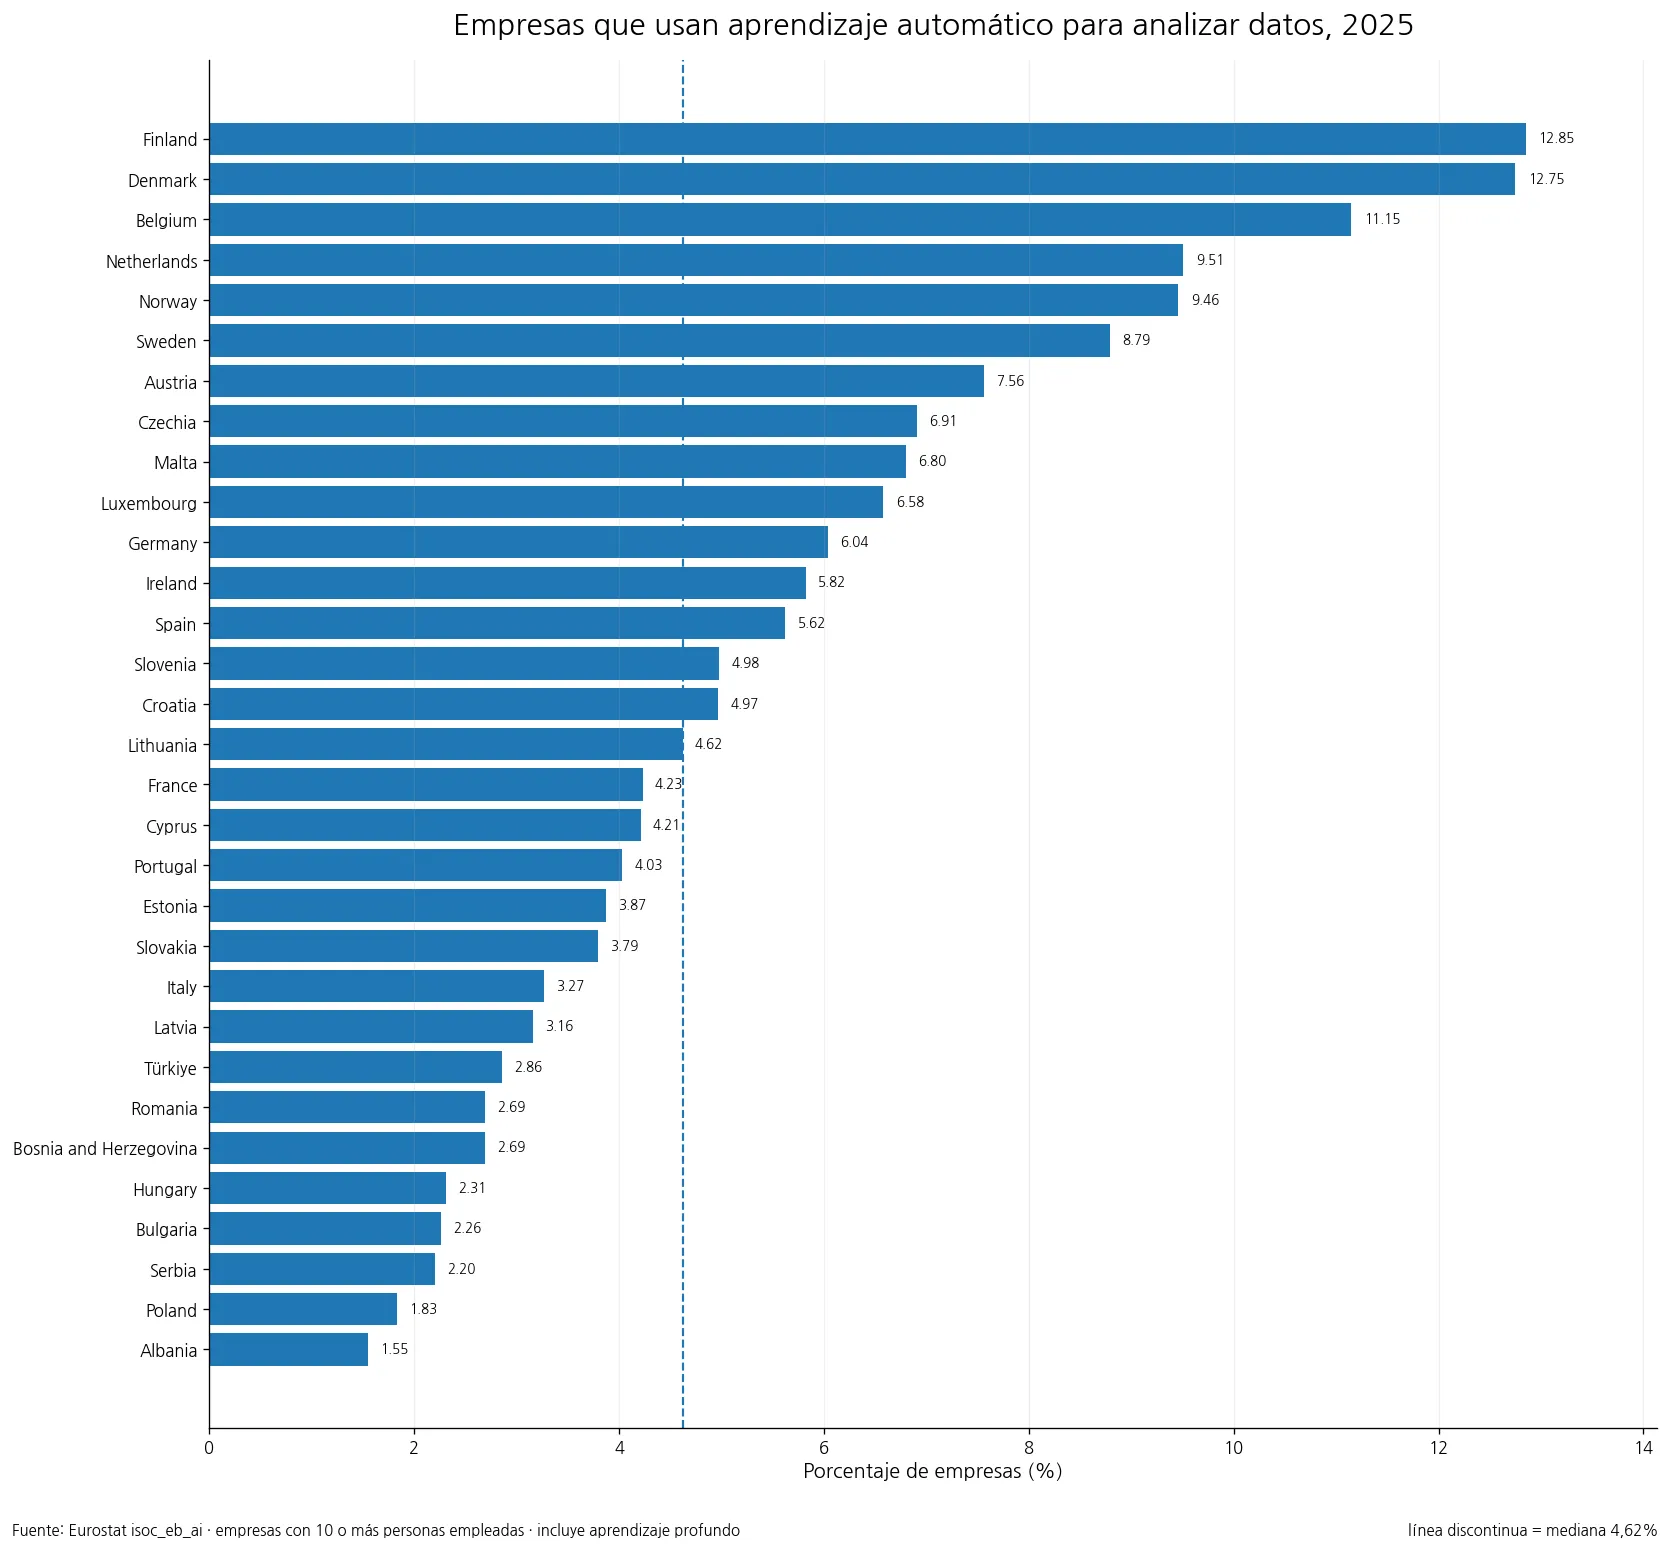
Eurostat publica datos de 2025 para 31 países europeos sobre la proporción de empresas que utilizan aprendizaje automático, incluido el aprendizaje profundo, para analizar datos. La población empresarial se limita a entidades con 10 o más personas empleadas y la unidad es el porcentaje de empresas. Por tanto, un valor del 10% significa que aproximadamente una de cada diez empresas incluidas en el ámbito de la encuesta declaró usar aprendizaje automático para análisis de datos. No significa que el 10% de los trabajadores utilice esta tecnología ni representa a las microempresas que quedan fuera del umbral de tamaño.
Finlandia registró el valor más alto, con 12.85%, seguida muy de cerca por Dinamarca, con 12.75%, y Bélgica, con 11.15%. La mediana de las 31 observaciones fue 4.62% y la media 5.46%. Solo 3 países alcanzaron al menos el 10%, mientras que 8 quedaron por debajo del 3%. El máximo fue aproximadamente 8.3 veces el mínimo, una diferencia amplia pese a que todas las observaciones comparten año, unidad y definición estadística.
Índice
Qué mide exactamente este indicador de Eurostat
El indicador E_AI_TML de Eurostat es más específico que una medida general de adopción de inteligencia artificial. Pregunta si una empresa utiliza aprendizaje automático, incluido el aprendizaje profundo, para el análisis de datos. Una empresa puede usar otras tecnologías de IA —por ejemplo reconocimiento de voz, procesamiento del lenguaje, visión artificial o IA generativa— y no quedar incluida aquí si no emplea aprendizaje automático con la finalidad analítica definida. En cambio, los modelos de predicción, clasificación o aprendizaje profundo aplicados a flujos de análisis pueden formar parte de esta categoría.
También importa el límite de la población observada. La serie se refiere a empresas con 10 o más personas empleadas y sigue la cobertura sectorial de las estadísticas de Eurostat sobre TIC en las empresas. Por ello, la comparación sirve para medir la difusión de un uso concreto del aprendizaje automático dentro de una población empresarial estandarizada, pero no constituye un censo de todas las organizaciones ni de todas las formas posibles de uso de IA.
Solo tres países superaron el 10% y la mayoría quedó por debajo del 5%
De los 31 países, 13 registraron un 5% o más y 18 quedaron por debajo del 5%. En otras palabras, en más de la mitad de los países observados menos de una de cada veinte empresas cubiertas declaró usar aprendizaje automático para analizar datos. Finlandia, Dinamarca y Bélgica fueron los únicos 3 países con al menos un 10%. La diferencia entre Finlandia y Dinamarca fue de apenas 0,10 puntos porcentuales, pero entre Bélgica, en tercer lugar, y los Países Bajos, en cuarto, fue de 1,64 puntos.
| País | Empresas (%) |
|---|---|
| Finland | 12.85 |
| Denmark | 12.75 |
| Belgium | 11.15 |
| Netherlands | 9.51 |
| Norway | 9.46 |
| Sweden | 8.79 |
| Austria | 7.56 |
| Czechia | 6.91 |
| Malta | 6.80 |
| Luxembourg | 6.58 |
Varias observaciones del norte de Europa se situaron en la parte alta. Finlandia y Dinamarca superaron el 12%, Noruega llegó al 9,46% y Suecia al 8,79%. Este patrón es descriptivo, no una explicación causal. Los datos por sí solos no permiten determinar cuánto influyen la estructura sectorial, el tamaño de las empresas, la infraestructura de datos, la disponibilidad de especialistas, la inversión, la gestión o la regulación. Lo que se observa es la frecuencia de un caso de uso concreto durante 2025.
La mediana del 4,62% describe mejor el centro de la distribución
La media, 5.46%, fue superior a la mediana, 4.62%, porque los valores cercanos al 9–13% del extremo superior elevaron el promedio aritmético. El primer cuartil fue 3.01% y el tercero 6.86%, de modo que la mitad central de los países se situó aproximadamente entre esas dos cifras. La desviación estándar fue de 3.15 puntos porcentuales. En una distribución de este tipo conviene leer la media junto con la mediana y los cuartiles.
Lituania coincidió exactamente con la mediana, con 4,62%. Francia, con 4,23%, Chipre, con 4,21%, y Portugal, con 4,03%, quedaron algo por debajo, mientras que Eslovenia, con 4,98%, y Croacia, con 4,97%, quedaron algo por encima. En la zona central muchas diferencias entre países son pequeñas; hacia los extremos, en cambio, la separación aumenta. Una clasificación ordinal puede ocultar esta diferencia entre posiciones próximas y diferencias realmente grandes.
Ocho países registraron menos del 3%
8 de las 31 observaciones quedaron por debajo del 3%. Albania tuvo el valor más bajo, con 1.55%, seguida por Polonia con 1,83%, Serbia con 2,20%, Bulgaria con 2,26% y Hungría con 2,31%. Rumanía y Bosnia y Herzegovina registraron 2,69%, y Türkiye 2,86%. En esos países, el uso declarado de aprendizaje automático para análisis de datos seguía siendo relativamente poco frecuente entre las empresas incluidas en la encuesta en 2025.
| País | Empresas (%) |
|---|---|
| Albania | 1.55 |
| Poland | 1.83 |
| Serbia | 2.20 |
| Bulgaria | 2.26 |
| Hungary | 2.31 |
| Bosnia and Herzegovina | 2.69 |
| Romania | 2.69 |
| Türkiye | 2.86 |
| Latvia | 3.16 |
| Italy | 3.27 |
Un porcentaje bajo no equivale a ausencia de inteligencia artificial. Las empresas pueden utilizar otras herramientas de IA, aplicar aprendizaje automático a otra función o describir internamente sus sistemas con términos diferentes de la categoría estadística. Este indicador ofrece deliberadamente una visión estrecha. Esa precisión lo hace útil para comparar un mismo caso de uso, pero también limita las conclusiones que pueden extraerse sobre la digitalización general.
Aprendizaje automático y adopción total de IA no son lo mismo
Varios indicadores empresariales de IA pueden parecer casi idénticos por su nombre. Sin embargo, la proporción de empresas que usa alguna tecnología de IA, la proporción que utiliza IA para analizar datos y la proporción que emplea aprendizaje automático para analizar datos responden a preguntas distintas. El primero tiene el alcance tecnológico más amplio. El indicador actual es más restrictivo porque exige simultáneamente una tecnología concreta y una finalidad concreta.
Esta diferencia ayuda a entender por qué un país puede mostrar otra cifra en una estadística de IA más general sin que exista contradicción. Una empresa que utiliza IA generativa para redactar documentos, pero no emplea aprendizaje automático en sus procesos de análisis, puede contar en una medida amplia de IA y quedar fuera de esta. Antes de comparar indicadores conviene igualar la definición del numerador, el umbral de tamaño empresarial, la cobertura sectorial, el año y la unidad.
Una mayor adopción no demuestra automáticamente una mayor productividad
Que un porcentaje mayor de empresas utilice aprendizaje automático no prueba por sí solo que una economía tenga más productividad ni que las empresas usuarias obtengan mayores beneficios. El indicador registra la existencia del uso, pero no su intensidad, la calidad de los modelos, la importancia de las decisiones que apoyan, el ahorro de costes o el efecto sobre las ventas. Para conectar adopción y resultados económicos hacen falta datos de empresa sobre inversión, cualificaciones, sector, producción y productividad.
También es posible la situación inversa: un país con una tasa nacional baja puede tener un pequeño grupo de empresas muy avanzadas que empleen sistemas sofisticados. El promedio nacional resume toda la distribución empresarial en un único porcentaje y no separa líderes, seguidores y no usuarios. Por ello, esta estadística responde mejor a la pregunta “¿qué tan extendido está el uso?” que a “¿qué tan bien se utiliza?”.
Un solo año no permite medir la velocidad de difusión
Todas las observaciones de esta comparación corresponden a 2025. Eso facilita una comparación transversal limpia, pero no indica qué países están acelerando. Un valor del 6% puede ser el resultado de un crecimiento rápido desde una base muy baja o de varios años de estabilidad. Para analizar la difusión tecnológica es necesario seguir el mismo E_AI_TML en años anteriores y posteriores y calcular tanto cambios en puntos porcentuales como movimientos relativos entre países.
El análisis temporal también debe vigilar la continuidad metodológica. La redacción de la encuesta, las categorías tecnológicas y la cobertura empresarial pueden cambiar. Aunque el código estadístico parezca el mismo, un ajuste de definición puede crear una ruptura que no debería interpretarse como un salto real de comportamiento. La comparación más sólida utiliza periodos con metadatos compatibles y señala explícitamente cualquier cambio metodológico.
Qué resume la distribución de 2025
La distribución deja tres conclusiones descriptivas. Primero, el aprendizaje automático para análisis de datos todavía no era una práctica extendida en el país típico de este conjunto: la mediana fue 4.62% y 18 países quedaron por debajo del 5%. Segundo, la dispersión fue grande, con 11.30 puntos porcentuales entre Finlandia y Albania. Tercero, se trata de una medida específica de adopción y no de una puntuación general de capacidad nacional en IA, digitalización o rendimiento económico.
Las extensiones más útiles serían combinar esta serie con otros indicadores empresariales de IA y construir una serie temporal. La comparación por tecnologías puede mostrar si el aprendizaje automático ocupa una posición central o secundaria dentro de la adopción de IA de cada país. La dimensión temporal permitiría saber si las diferencias se reducen, aumentan o cambian de composición. La fotografía de 2025 funciona como una línea de base clara porque las 31 observaciones comparten año y una definición empresarial común.
Preguntas frecuentes
¿Qué mide el porcentaje de empresas que usa aprendizaje automático?
Mide la proporción de empresas con 10 o más personas empleadas que declara usar aprendizaje automático, incluido aprendizaje profundo, para analizar datos. Es más específico que la adopción total de IA.
¿Qué país tuvo el valor más alto en 2025?
Finlandia registró 12.85%, seguida por Dinamarca con 12.75% y Bélgica con 11.15%.
¿Cuál fue la mediana de los 31 países?
La mediana fue 4.62%. La mitad central de las observaciones se situó aproximadamente entre 3.01% y 6.86%.
Artículos relacionados
Los mapas ofrecidos por Green Map son mapas editados y elaborados por nosotros, utilizando como referencia fuentes de datos geográficos abiertos como geoBoundaries, Natural Earth, OpenStreetMap y datos abiertos de gobiernos y organismos públicos.
Las imágenes de los mapas no redistribuyen los archivos de datos originales. Son materiales visuales editados y diseñados para su uso en educación, presentaciones, documentos, blogs y otras referencias gráficas. Este aviso informa sobre las principales fuentes de datos utilizadas como referencia en la elaboración de los mapas de Green Map.